软件截图
软件介绍
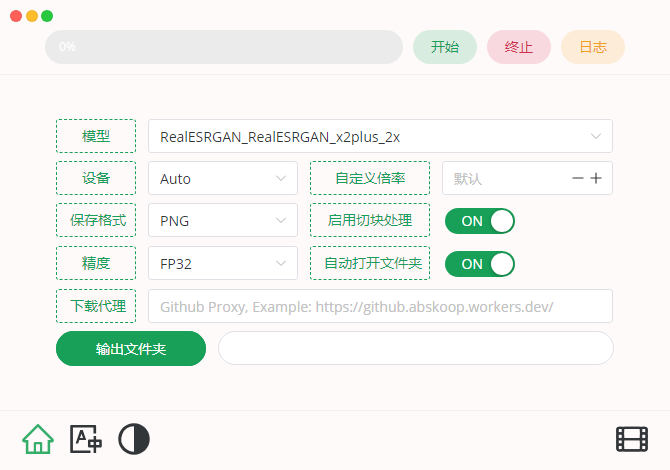
Final2x 是由 EutropicAI 开发的一款开源跨平台 AI 图片超分辨率工具,覆盖 Windows、macOS 和 Linux 三大桌面平台。项目采用前后端分离架构:前端基于 Electron + Vue(Naive UI 组件库)提供图形界面,后端核心 Final2x-core 以 Python CLI 形式运行,底层推理引擎为同团队维护的 cccv 库——一个基于 PyTorch 构建的图像/视频修复与超分辨率推理框架。Final2x 的核心价值在于将学术界前沿的超分辨率模型(RealESRGAN、RealCUGAN、SwinIR、DAT、HAT 等)封装为零门槛的桌面应用,用户无需编写代码或配置推理环境,即可通过图形界面完成图片的 AI 放大与降噪。此外,项目支持从远程 GitHub 仓库或本地路径加载自定义模型,为进阶用户提供了灵活的模型扩展能力。项目遵循 BSD 3-Clause 开源许可。
核心功能
多架构超分辨率引擎:后端 cccv 推理库集成 10 大超分辨率网络架构——RRDB、SRVGG、UPCUNET、EDSR、SwinIR、SCUNet、DAT、SRCNN、HAT 及辅助网络 SpyNet,预注册超过 60 个预训练权重配置,覆盖 2x、3x、4x 放大倍率,用户可根据图片类型与画质需求自由选择。
RealESRGAN 系列模型:内置 RealESRGAN_x4plus(通用写实 4x 放大)、RealESRGAN_x4plus_anime_6B(动漫专用)、AnimeJaNai_HD_V3_Compact(高清动漫 2x)、AniScale_2_Compact、Ani4Kv2_Compact 以及 APISR 系列 GAN 模型,针对真实照片与动漫插画均有细分优化方案。
RealCUGAN 降噪放大:提供 Conservative(保守)、No_Denoise(无降噪)、Denoise1x/2x/3x(多级降噪)及 Pro 系列共 16 个预训练权重,支持 2x/3x/4x 放大,对老旧图片的噪点与压缩伪影处理表现突出。
学术前沿模型支持:集成 SwinIR(基于 Swin Transformer 的图像修复)、DAT(Dual Aggregation Transformer)、HAT(Hybrid Attention Transformer)等最新学术架构,各架构提供 S/M/L 及 light 等多种规模变体,在 PSNR/SSIM 指标上代表当前技术前沿。
SCUNet 图像去噪:内置 SCUNet 的 color_50、color_real_psnr 和 color_real_gan 三个 1x 权重,专注于不改变分辨率的纯降噪与画质增强场景。
视频超分辨率与插帧:cccv 后端额外支持 EDVR(视频超分辨率)、AnimeSR(动漫视频 4x 放大)、RIFE(实时视频插帧)及 DRBA 视频帧插值模型,具备 VapourSynth 插件接口,可集成至视频处理管线。
自定义模型加载:支持从远程 GitHub 仓库 URL 或本地路径自动注册并加载用户自训练或第三方模型,无需修改源码即可扩展模型库,灵活度极高。
多配置输入方式:CLI 后端支持 YAML 配置文件、JSON 字符串及 Base64 编码三种参数传递方式,便于脚本化批量处理与自动化管线集成。
适用人群
需要将低分辨率旧照片 AI 放大的普通用户与摄影爱好者
处理动漫截图、插画素材放大的二次元创作者与壁纸爱好者
希望零代码体验学术前沿超分辨率模型的 AI 研究者与学生
有批量图片放大需求的设计师与印刷从业者
需要视频超分与插帧、具备 VapourSynth 使用经验的视频后期工作者
拥有自训练模型并需要快速部署推理的深度学习开发者
优缺点分析
优点:
模型库深度突出:60+ 预训练权重覆盖通用写实、动漫专用、纯降噪等多个细分场景,模型丰富度在同类 GUI 超分工具中处于领先水平,且架构选型紧跟学术前沿(DAT、HAT 等 2023-2024 年发表的 Transformer 模型均已集成)。
自定义模型生态:通过 cccv 的
AutoModel.from_pretrained()接口,支持从远程仓库或本地路径热加载自定义模型,这在开源超分辨率 GUI 工具中较为少见,赋予了项目高度的可扩展性。跨平台一致体验:Windows/macOS/Linux 三平台均有官方构建,macOS 与 Linux 用户也能获得完整的 AI 超分能力,不再被锁定于 Windows 专属工具。
推理能力延伸至视频:cccv 后端不仅限于静态图片,还覆盖了视频超分(EDVR/AnimeSR)与视频插帧(RIFE/DRBA),并提供 VapourSynth 接口,潜力远超一般看图放大工具。
开源免费:BSD 3-Clause 宽松许可,无功能限制、无水印、无订阅费用。
缺点:
依赖链较重:运行后端需要 Python ≥ 3.10 与 PyTorch ≥ 2.0 环境,PyTorch 本身体积达数 GB(含 CUDA 运行时),对磁盘空间和首次安装配置的要求远高于基于 ncnn/vulkan 的同类工具(如 Waifu2x-ncnn-vulkan)。
GPU 依赖度高:深度学习推理对 GPU 加速依赖明显,无独立显卡或仅有核显的设备在处理大尺寸图片时耗时显著增加,纯 CPU 推理体验受限。
macOS 签名缺失:macOS 版本未经 Apple 公证,首次启动需手动执行
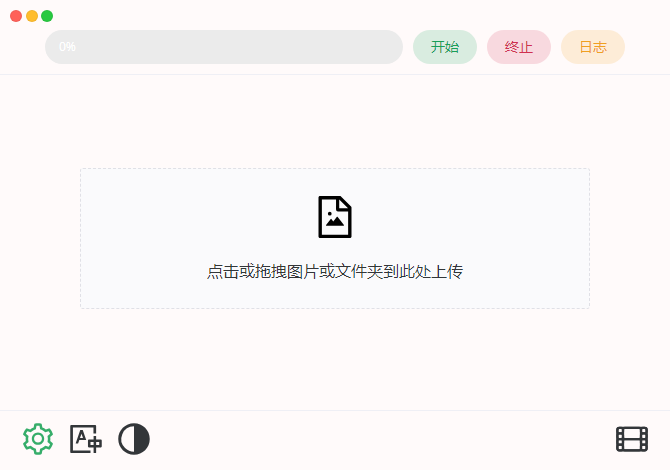
xattr -cr命令解除安全隔离,对非技术用户构成使用门槛。GUI 功能相对精简:桌面端界面以"选模型 → 选图片 → 运行"为核心流程,缺少实时预览对比、ROI 区域裁剪预览、批量任务队列管理等进阶 GUI 功能。
文档与引导不足:README 较为精简,模型选择指南(何种场景选用何种模型/权重)缺乏系统性文档,新用户面对 60+ 个模型配置时可能无所适从。
系统要求
操作系统:Windows 10/11、macOS 10.15+、Linux(Debian/Ubuntu 等主流发行版)
运行时依赖:Python ≥ 3.10、PyTorch ≥ 2.0(桌面版已捆绑核心组件,Linux 需手动安装)
GPU 加速(推荐):NVIDIA 显卡 + CUDA 11.8/12.x 驱动,或 Apple Silicon(MPS 后端);AMD 显卡可通过 ROCm 有限支持
内存:建议 8 GB 以上系统内存;使用大型模型(HAT-L、DAT-2)处理高分辨率图片时建议 16 GB+
显存:建议 4 GB 以上独立显卡显存;Transformer 架构模型(SwinIR-L、HAT、DAT)在高分辨率输入时显存消耗较大,建议 6-8 GB 以上
磁盘空间:PyTorch + CUDA 运行时约 3-5 GB,模型权重文件视选用数量而定(单个权重约 10-200 MB)
下载地址
声明:本站为非盈利性技术交流平台。所有资源均来自互联网或官方发布,版权归原作者所有。如有侵犯您的权益,请联系我们(fzxzcopy@163.com),我们将第一时间处理。


