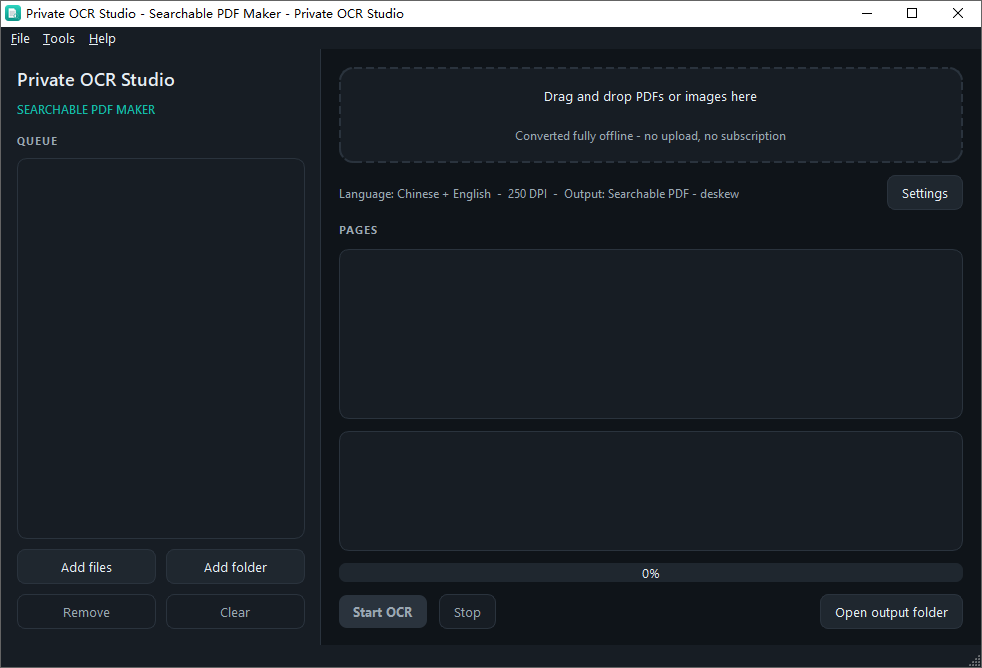
软件截图
软件介绍
Private OCR Studio 是一款专注于隐私保护的本地化 OCR(光学字符识别)工具,适用于 Windows 10/11(x64)平台。扫描件本质上只是图像——无法搜索、无法复制文字、无法编辑。市面上绝大多数 OCR 工具通过将文件上传至云端完成识别,这不仅速度受限于网络带宽,而且对合同、发票、身份证件、医疗及法律文书等敏感文档而言存在严重的隐私泄露风险。Private OCR Studio 的核心设计理念正是解决这一痛点:所有文字识别均在用户设备本地完成,不联网、不上传、无遥测、无账户、无订阅。底层由 RapidOCR(基于百度 PaddleOCR PP-OCR 的 ONNX 推理模型)驱动文字识别,结合 PyMuPDF 进行 PDF 渲染与可搜索文本层注入,仅需 CPU 即可运行,无需 GPU 加速硬件。该工具同时上架于 Microsoft Store,面向小型企业、会计、律师、研究人员、学生及所有关心文档隐私的数字化办公用户。
核心功能
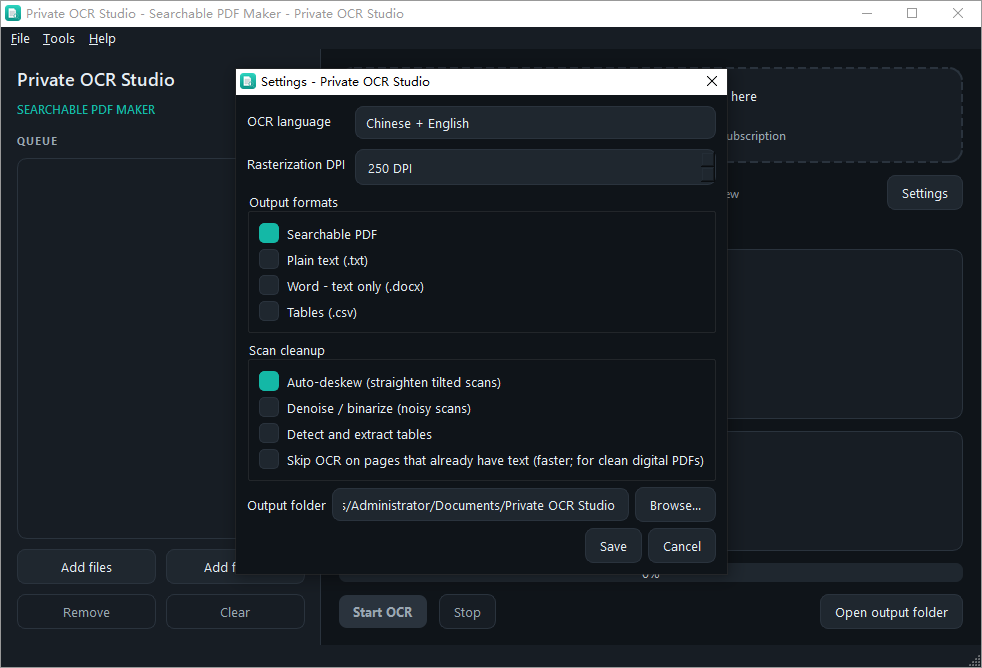
可搜索 PDF 输出:在保留原始页面视觉外观的基础上,为扫描 PDF 添加可选中、可搜索的文本层。处理后的 PDF 在视觉上与原件一致,但支持全文检索与文字复制,是文档数字化归档的理想输出格式。
多格式导出:识别结果支持导出为纯文本(.txt)、Word 文档(.docx)及 CSV 表格(.csv),覆盖从文字摘录到结构化数据提取的多种下游需求。
批量文件夹处理:支持将整个文件夹拖入工具进行队列化批量 OCR 识别,文件按序处理,无需逐个手动添加,适合大量扫描件的集中处理场景。
表格提取:具备从扫描件中重建表格结构并导出为 CSV 的能力,适用于扫描发票、财务报表、统计表格等含结构化数据的文档。
扫描件清理:内置自动倾斜校正(Deskew/Straighten)和降噪(Denoise)功能,可对歪斜、噪点较多的低质量扫描件进行预处理,提升后续 OCR 识别准确率。
隐私脱敏(Privacy Redaction):支持基于模式匹配的自动隐私脱敏功能,可检测并遮盖文档中的电子邮件地址、电话号码、身份证号、银行卡号及 IP 地址等敏感信息,适用于文档分享前的隐私清理。
多语言 OCR 支持:内置多种语言识别模型,模型文件随软件捆绑供离线使用,无需额外联网下载语言包。
拖放式操作:支持直接拖放文件或文件夹至窗口即可启动识别流程,操作极其简洁。
适用人群
处理合同、法律文书、医疗记录等敏感文档,对数据隐私有严格要求的律师、会计及合规人员
需要将大量纸质档案数字化归档的小型企业与行政办公人员
学术研究人员与学生,需从扫描的文献、论文或手写笔记中提取可编辑文字
对云端 OCR 服务的安全性持保留态度,偏好完全本地化处理方案的隐私敏感型用户
没有高性能 GPU 设备但仍需要高质量 OCR 能力的普通 PC 用户
优缺点分析
优点:
隐私保障彻底:这是该软件最核心的竞争力。100% 离线运行,无遥测、无账户体系、无订阅机制,文档数据完全不离开用户设备。对于受 GDPR、HIPAA 等合规要求约束或自身隐私意识较强的用户,这一特性具有不可替代的价值。
OCR 引擎选型合理:底层采用 RapidOCR(PaddleOCR PP-OCR ONNX 模型),这是目前开源 OCR 领域综合精度与速度表现最优秀的方案之一,尤其在中文、日文等 CJK 字符识别上优势明显。ONNX 格式的推理模型确保了 CPU-only 环境下的执行效率。
可搜索 PDF 的实现质量:通过 PyMuPDF 注入文本层的技术路径成熟可靠,输出的 PDF 保留了原始页面排版,同时具备可搜索性,这在法律和财务归档场景中是刚需功能。
无需 GPU 硬件:纯 CPU 推理降低了硬件门槛,普通办公电脑即可运行,不像部分基于 Transformer 的大模型 OCR 方案需要 CUDA 显卡支持。
批量处理能力:文件夹级批量队列处理对于需要集中转换大量扫描件的用户而言是实质性的效率提升。
缺点:
安装包体积较大:软件包约 394 MB,主要由捆绑的多语言 OCR 模型文件贡献。对于磁盘空间有限的设备或仅需单一语言识别的用户,略显臃肿。
隐私脱敏依赖模式匹配:自动脱敏功能基于正则表达式等模式匹配实现,存在漏检(遗漏非标准格式的敏感信息)和误检(遮盖无害文本)的可能。官方明确声明该功能仅作为辅助工具,用户在分享敏感文档前必须逐页人工复核,不可完全依赖自动化结果。
仅限 Windows 平台:当前版本仅支持 Windows 10/11(x64),macOS 和 Linux 用户无法使用。对于跨平台工作流的用户,需要寻找替代方案。
手写体识别能力有限:PaddleOCR PP-OCR 模型主要针对印刷体优化,对手写文字的识别准确率会显著下降,尤其是潦草笔迹或非标准书写。
缺乏版面分析的深度定制:对于复杂版面(多栏、图文混排、水印覆盖文字等),当前的自动版面分析可能出现段落合并或阅读顺序错乱的情况,缺少手动指定识别区域的高级交互。
系统要求
操作系统:Windows 10 / 11(64 位)
处理器:支持 SSE/AVX 指令集的现代 x64 CPU(ONNX Runtime 推理要求)
内存:建议 4 GB RAM 以上;处理大型 PDF(数十至数百页)时内存消耗会显著增加
磁盘空间:安装约需 400 MB(含捆绑 OCR 模型文件);额外需预留输出文件的存储空间
GPU:不需要,纯 CPU 推理
其他:无需联网、无需注册账户即可使用全部功能
下载地址
声明:本站为非盈利性技术交流平台。所有资源均来自互联网或官方发布,版权归原作者所有。如有侵犯您的权益,请联系我们(fzxzcopy@163.com),我们将第一时间处理。


