软件截图
软件介绍
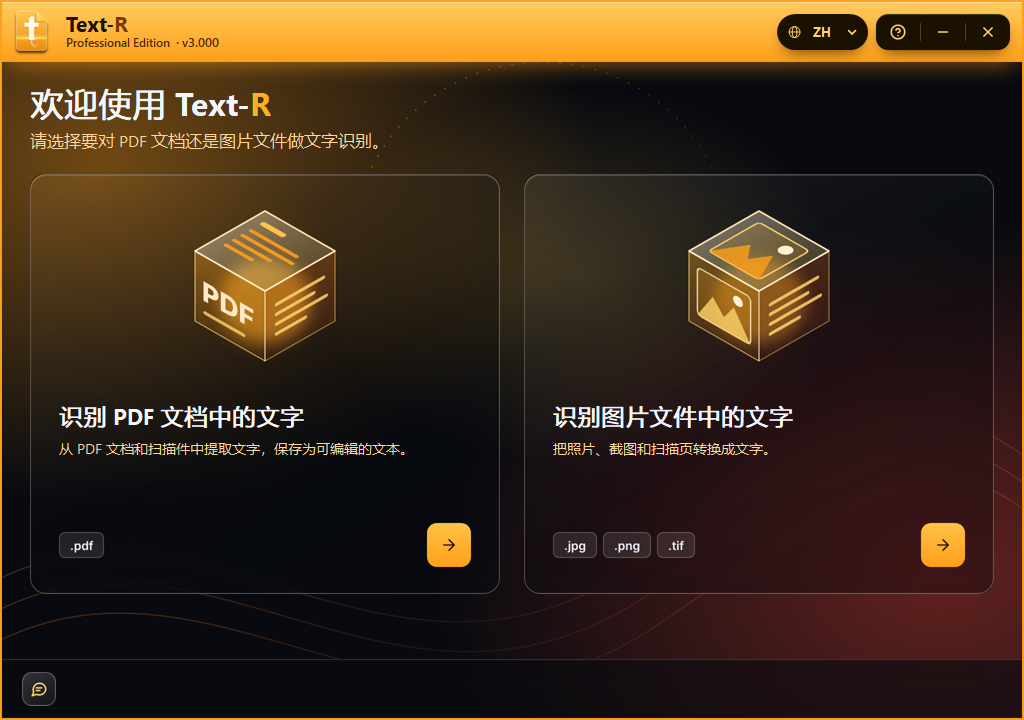
ASCOMP Text-R 是一款由德国 ASCOMP Software GmbH 开发的 Windows 平台 OCR 文字识别软件,当前版本号为 3.000。其核心定位明确:将扫描件、手机拍摄的纸质文档、截图以及不带文本层的 PDF,转换为可复制、可检索的文本内容。
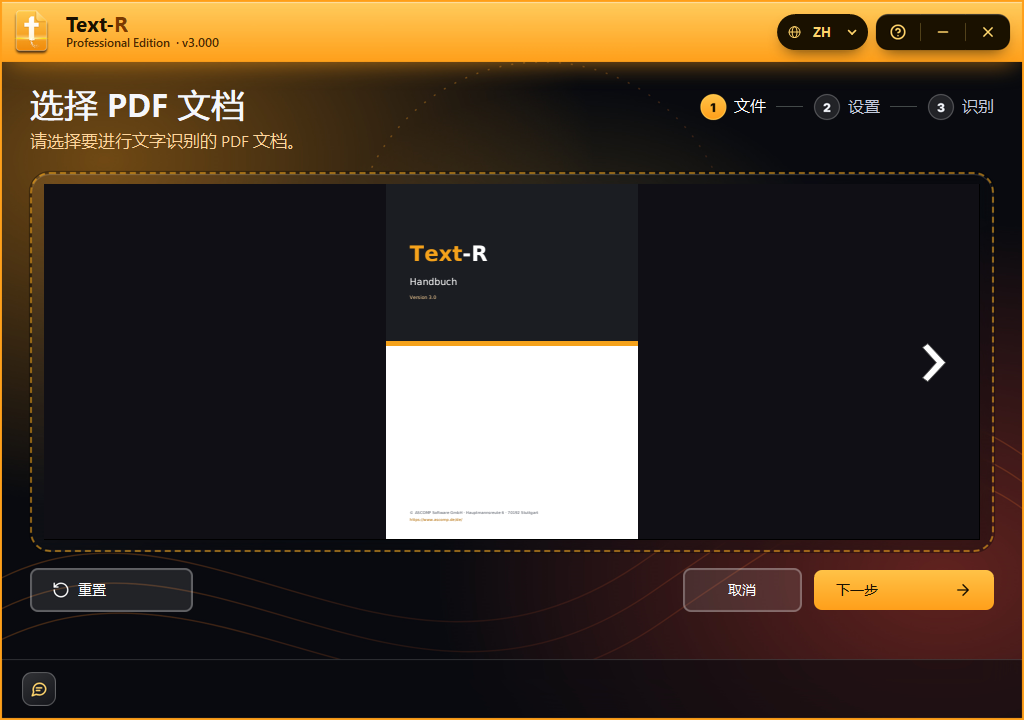
与常见的在线 OCR 服务不同,Text-R 的识别流程完全在本地完成,不依赖云端接口或第三方 AI 服务,也不需要用户账号。文件不会上传至任何服务器,这一设计使其适用于合同、人事档案、病历、税务凭证等对保密性有要求的文档场景,同时也降低了 GDPR 合规方面的顾虑。识别内核采用开源 Tesseract 引擎,ASCOMP 在其上封装了一层图形化操作界面,用户只需选择文件、设置选项、执行识别、保存结果四步即可完成工作,无需命令行或其他技术准备。
核心功能
多格式识别输入:支持 PDF(含多页文档)、JPG、PNG、TIFF、BMP 等常见图像格式,可处理传真件、低对比度原件与智能手机翻拍照片。
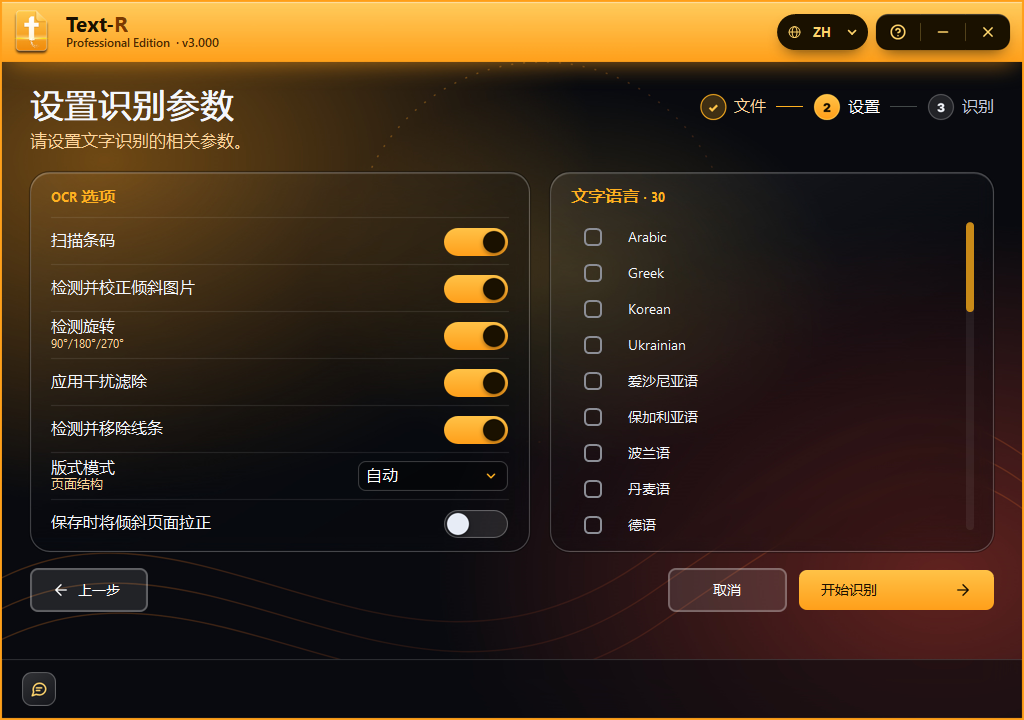
图像预处理:自动校正倾斜页面(deskew),识别 90/180/270 度旋转并自动摆正,提供噪点滤镜去除扫描伪影与杂色,并可检测并移除表格线与分隔线,避免其干扰字符识别。
版面模式选择:可指定自动、单列、单一文本块或稀疏文本四种读取模式,后两者适用于表单、名片等非连续排版内容。
多语言并行识别:内置约 30 种语言数据包,涵盖德、英、法、西、意、荷、波、俄、乌克兰、土耳其、希腊等语种,支持同一文档单次识别多种语言,适合含英文术语的中文或欧洲语言合同。
条码与二维码读取:可选开启条形码与二维码解析,并将结果并入输出内容。
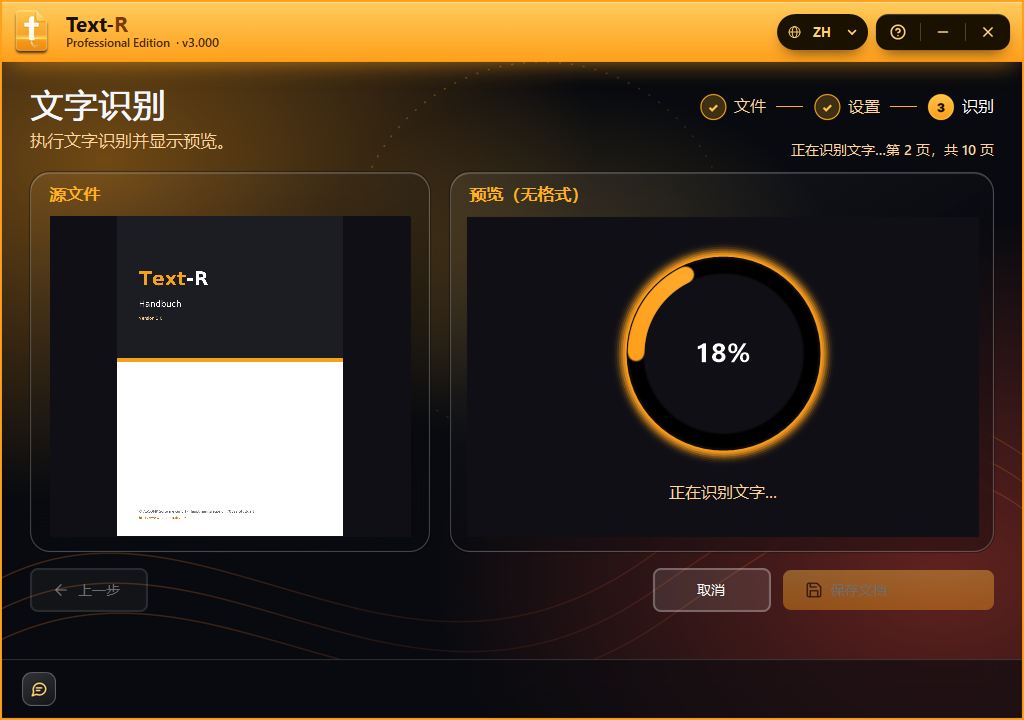
灵活的结果导出:可生成保留原始版式的可搜索 PDF(附加不可见文本层,支持全文检索与复制),或导出为 RTF(供 Word、LibreOffice 使用)、TXT(ASCII 或 Unicode)与 XML;保存前提供原文与识别文本的对照预览,便于核对。
后台处理与进度反馈:识别任务在后台逐页执行,显示进度并支持中途取消。
适用人群
需批量数字化纸质合同、发票与台账的行政、财务人员
处理病历、客户档案等敏感资料且不便使用在线 OCR 的医疗机构与律所
需要为历史扫描 PDF 建立全文检索索引的档案管理与公共机构用户
偶尔需要从截图或图片中提取文字的自由职业者与家庭用户
优缺点分析
优点:
数据边界清晰:识别过程不触网、不上传、不留存账号数据,从架构上消除了内容外流的可能,这是其区别于在线 OCR 的主要技术优势。
预处理链路完整:倾斜校正、旋转检测、噪点过滤、线条移除四步前置处理直接作用于识别精度,对翻拍件与传真件的容错能力优于无预处理的裸引擎调用。
输出格式覆盖面合理:可搜索 PDF 兼顾版式保真与检索需求,RTF/TXT/XML 则便于后续进入文档管理或结构化处理流程。
授权模式简单:29.90 美元一次性购买,提供 14 天完整功能试用,无订阅制绑定。
缺点:
引擎能力存在上限:Tesseract 对手写体、严重褪色印刷与原图分辨率过低的文档识别效果有限,官方亦明确说明此类素材无法被任何 OCR 完美处理。
仅限 Windows:仅提供 64 位 Windows 版本,支持 Windows 10/11 及 Windows Server 2016/2019/2022/2025,无 macOS 或 Linux 原生版本。
缺少批量队列与自动化接口:界面以单文件交互为主,未提供命令行批量处理或监视文件夹自动识别等面向大规模流水线的能力,处理量级较大时需逐次操作。
无版面重构能力:导出 RTF 时不会还原原文档的排版结构,复杂多栏版式的重排工作仍需人工介入。
系统要求
操作系统:Windows 11、Windows 10(64 位);Windows Server 2016 / 2019 / 2022 / 2025
处理器:Intel 兼容处理器,支持 Windows on ARM
内存:最低 2 GB,建议 4 GB
硬盘空间:50 MB
其他:识别过程无需联网;附加语言包与输出文件另行占用磁盘空间
版本与价格:当前版本 3.000,标准版 / 专业版 29.90 美元,提供 14 天试用
下载地址
声明:本站为非盈利性技术交流平台。所有资源均来自互联网或官方发布,版权归原作者所有。如有侵犯您的权益,请联系我们(fzxzcopy@163.com),我们将第一时间处理。


